Pesquisadores usaram o Claude da Anthropic para invadir a OpenAI
Em uma reviravolta que captura o estranho novo estado da segurança de IA, pesquisadores de segurança independentes usaram o Claude, da Anthropic, para invadir a OpenAI, expondo rachaduras nas defesas da criadora do ChatGPT, noticiou o The Wall Street Journal na noite de quinta-feira.
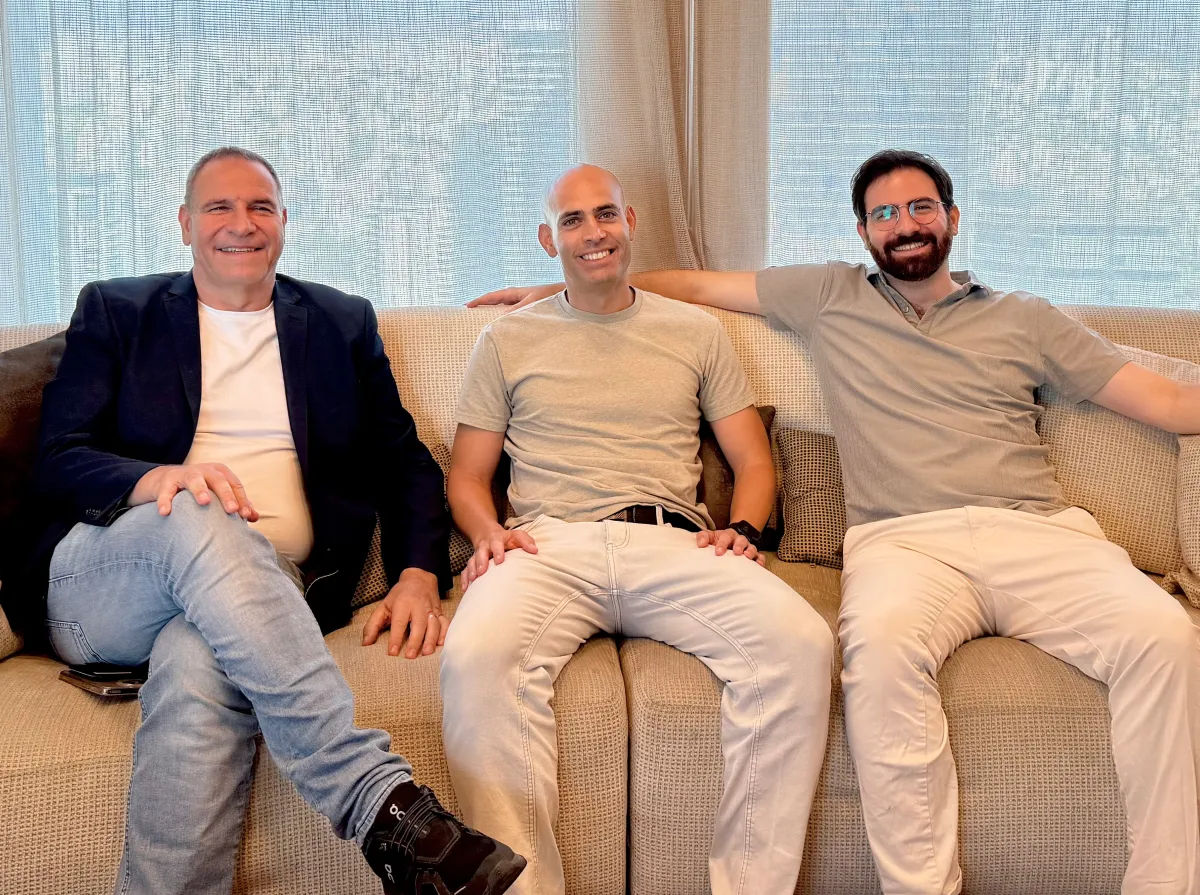
Uma equipe de segurança de três pessoas da startup Hacktron AI realizou o ataque como parte de um programa de bug-bounty (recompensa por bugs) da OpenAI. A Hacktron relatou suas descobertas à OpenAI, que concedeu à startup um prêmio de US$ 6.500. A equipe conseguiu encadear duas vulnerabilidades críticas para obter acesso a várias contas do ChatGPT de funcionários da OpenAI, o que lhes deu entrada no software da empresa.
A OpenAI diz que resolveu os problemas descobertos pela Hacktron, o que acontece justamente em um momento em que as principais empresas de IA estão sob crescente pressão sobre segurança.
Este incidente ocorre várias semanas depois que os próprios agentes de IA da OpenAI romperam o isolamento durante uma avaliação de cibersegurança e hackearam o Hugging Face, demonstrando o quão capazes os modelos de IA estão se tornando em tomar suas próprias decisões. Isso também destaca como a tecnologia comercial de prateleira pode ser usada para encontrar vulnerabilidades até mesmo na infraestrutura das empresas mais avançadas.
“Por US$ 200 por mês, qualquer pessoa pode usar essas ferramentas e invadir uma empresa como a OpenAI”, disse Matt Fredrikson, CEO da empresa de segurança de IA Gray Swan, ao TechCrunch. “Se isso pode acontecer com eles — e eu não acho que eles tenham sido negligentes recentemente com a higiene de cibersegurança — pode acontecer com qualquer um.”
Ou, como um especialista em IA observou nas redes sociais: “[A Hacktron] usou o Opus 5 para realizar o ataque... A pergunta que será feita é: se esses três caras conseguem fazer isso, o que um Estado-nação pode fazer.”
Os pesquisadores encontraram um caminho para entrar na OpenAI em 25 de julho por meio de uma falha no Discourse, o software de terceiros que alimenta o fórum comunitário da OpenAI.
De acordo com um blog que os pesquisadores publicaram, o ponto de entrada foi um envio de imagem comum. Quando os usuários postavam arquivos de imagem HEIF ou HEIC (o formato que os iPhones usam por padrão) no fórum da comunidade da OpenAI, o Discourse os passava por uma cadeia de ferramentas de bastidores para convertê-los em JPEGs padrão. Sua primeira parada foi o ImageMagick, um utilitário de código aberto com décadas de existência usado para redimensionar imagens. Como o kit de ferramentas usual do ImageMagick não consegue lidar com o formato da Apple, ele repassou o arquivo para outra biblioteca chamada libheif para fazer a decodificação.
Escondido dentro da libheif havia um bug de memória que expunha um caminho para um invasor inserir suas próprias instruções. Nesse caso, alimentar a biblioteca com uma imagem especialmente elaborada fez com que ela calculasse mal onde uma imagem estava posicionada em cima de outra, o que se mostrou suficiente para sequestrar o servidor.
O que pode ser desconfortável para a comunidade de cibersegurança é que esse bug já havia sido corrigido meses antes pelos desenvolvedores da libheif. Mas a correção nunca foi formalmente sinalizada como uma vulnerabilidade, o que significa que ela nunca recebeu um número CVE (vulnerabilidades e exposições comuns), a forma padrão da indústria para rastrear fraquezas de segurança conhecidas. A Hacktron diz que isso pode explicar por que o software usado pelo Discourse ainda estava executando a versão vulnerável.
Notavelmente, os pesquisadores disseram que o modelo Claude que estavam usando — uma versão especial do Opus 4.8 disponibilizada para pesquisadores de cibersegurança — não conseguiu criar um exploit funcional a princípio. Isso mudou da noite para o dia, quando a Anthropic lançou o Opus 5.
“O Opus 4.8 teve dificuldades em várias sessões para produzir um exploit funcional”, escreveu a Hacktron em uma postagem de blog. “Poucas horas após o lançamento do Opus 5, demos a ele o mesmo problema e ele teve sucesso.”
Uma vez dentro do servidor do Discourse, os pesquisadores encontraram outra falha que lhes permitiu assumir o controle das contas do ChatGPT e Codex dos usuários, incluindo aquelas pertencentes a funcionários da OpenAI.
“Nós então assumimos o controle da conta de um funcionário da OpenAI, cujo Codex estava conectado à organização GitHub da OpenAI”, escreveu a Hacktron em seu resumo do evento.
Nesse ponto, os pesquisadores alertaram a OpenAI, bem como o Discourse, que emitiu uma correção em 27 de julho.
O incidente coloca os holofotes sobre onde a linha é traçada para as capacidades dos modelos. O Claude Opus 5, a versão que finalmente quebrou o bug, não enfrentou nenhuma restrição de exportação de segurança, ao contrário da versão mais recente Mythos 5, que foi temporariamente bloqueada devido a preocupações sobre suas capacidades avançadas de hacking.
Esses são apenas os modelos fechados. Modelos de pesos abertos estão alcançando cada vez mais a fronteira em capacidades cibernéticas. Por exemplo, a organização sem fins lucrativos de segurança de IA SaferAI descobriu recentemente que o GLM-5.2 da empresa chinesa Z.ai estava apenas alguns meses atrás do GPT-5.5 da OpenAI e do Claude Opus 4.7 da Anthropic.
Como o fundador da Hacktron, Mohan Pedhapati, disse no X: “A IA está reduzindo a quantidade de expertise escassa necessária para desenvolver exploits. Um trabalho que antes levava meses agora pode levar dias.”