A PrismML espera que seu pequeno LLM mude a forma como todos nós usamos a IA
Se o laboratório de IA PrismML ainda não está no seu radar, deveria estar — não porque tenha levantado mundos e fundos (ainda não, apenas uma rodada seed de US$ 22,25 milhões), mas pelas mentes técnicas envolvidas e pela tecnologia potencialmente revolucionária para a indústria que está desenvolvendo.
A PrismML está apostando que grandes modelos de linguagem de raciocínio, capazes e de alto desempenho, de fato, não precisam ser grandes.
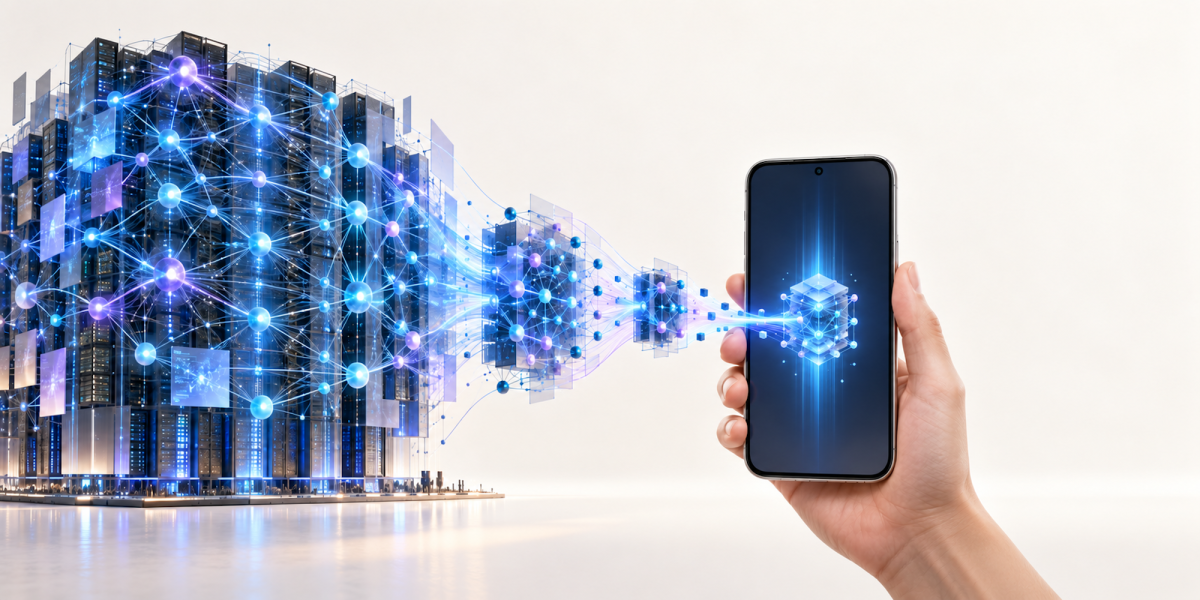
Ela está criando modelos de raciocínio tão pequenos que cabem em PCs e smartphones. (Há até rumores de que está em negociações com a Apple, embora o CEO Babak Hassibi tenha recusado comentar sobre isso com o TechCrunch.)
Na quinta-feira, a PrismML lançou o Bonsai 2 27B, o mais recente de sua família de modelos, que comprime o Qwen3.8 27B, um modelo de código aberto amplamente utilizado da Alibaba, para apenas 5,9 GB. Isso é pequeno o suficiente para caber em um PC e, possivelmente, em um smartphone de ponta. É uma redução de 9x a 10x na memória em comparação com o original.
A PrismML foi fundada por um grupo de pesquisadores do Caltech e é liderada por Hassibi, professor do Caltech e especialista em tecnologias de compressão. A startup também conta com Ion Stoica como conselheiro. Stoica é cofundador da Databricks (e de outras empresas) e diretor do famoso Sky Computing Lab de Berkeley, que deu origem a muitas tecnologias e startups, desde Letta até SGLang.
A PrismML também é apoiada pelos investidores Khosla Ventures, Cerberus Capital e Caltech.
Esta startup certamente não é a única empresa trabalhando em tecnologia de compressão de LLMs. A Multiverse Computing, fundada por um conhecido professor do Donostia International Physics Center, na Espanha, é outra. (E a Multiverse Computing já levantou uma grana preta.)
Mas Hassibi diz que a tecnologia de compressão da PrismML é única porque seus LLMs praticamente não perderam desempenho em comparação com os originais. O Bonsai 2 atinge 98% das pontuações agregadas de benchmark do Qwen. Isso é um aumento em relação ao primeiro Bonsai, lançado há alguns meses, em março, que alcançava 95%. Esse modelo original já foi baixado mais de 11 milhões de vezes, e os modelos ainda menores da PrismML foram baixados outras 2,6 milhões de vezes, segundo a empresa.
Portanto, isso mostra que os resultados de compressão da PrismML melhoraram de um lançamento para o outro. Se ela conseguirá algum dia atingir 100% de paridade de desempenho em benchmarks é uma questão que ainda precisa ser vista. A compressão provavelmente sempre terá algum impacto, diz Hassibi.
Ainda assim, a paridade perfeita em benchmarks é algo bastante acadêmico de qualquer forma. Os LLMs não são tão precisos em sua forma não compactada, e os benchmarks não refletem tão perfeitamente as tarefas reais, a ponto de uma degradação de 2% afetar significativamente o desempenho de um modelo no uso real. (Além disso, o software ao redor — a estrutura em que um modelo é executado — importa muito quando o assunto é precisão também.)
A PrismML diz que alcança isso encolhendo os “pesos” que compõem um modelo — pesos são, essencialmente, a informação que um modelo aprende e armazena durante o treinamento. Normalmente, cada peso exige 16 bits. A abordagem da PrismML, chamada de pesos “ternários”, simplifica isso para três: +1, ?1 ou 0. Com valores muito menores para armazenar em cada peso, o modelo ocupa dramaticamente menos espaço. (Para uma análise mais profunda da técnica de compressão, aqui está a página do Hugging Face do projeto.)
O próximo objetivo da startup é aplicar essa técnica de compressão a modelos ainda maiores. “Os próximos modelos que lançaremos, com sorte nos próximos meses, estarão na faixa de várias centenas de bilhões de parâmetros, e espero que seja mais fácil reter a inteligência neles”, disse Hassibi ao TechCrunch.
À medida que o tamanho do modelo cresce, ele acrescentou, “Há mais margem para poder compactá-los sem perder a inteligência. Então eu diria apenas que, como tendência geral, para modelos maiores, é mais fácil chegar a 100%.”
Stoica nos diz que está animado com essa tecnologia porque ela está tornando possível que modelos avançados rodem nos dispositivos dos usuários. “Você terá inteligência na ponta dos seus dedos, e ela será gratuita porque vai rodar no dispositivo que você já comprou. Também será privada, porque você não vai enviá-la para a nuvem.”